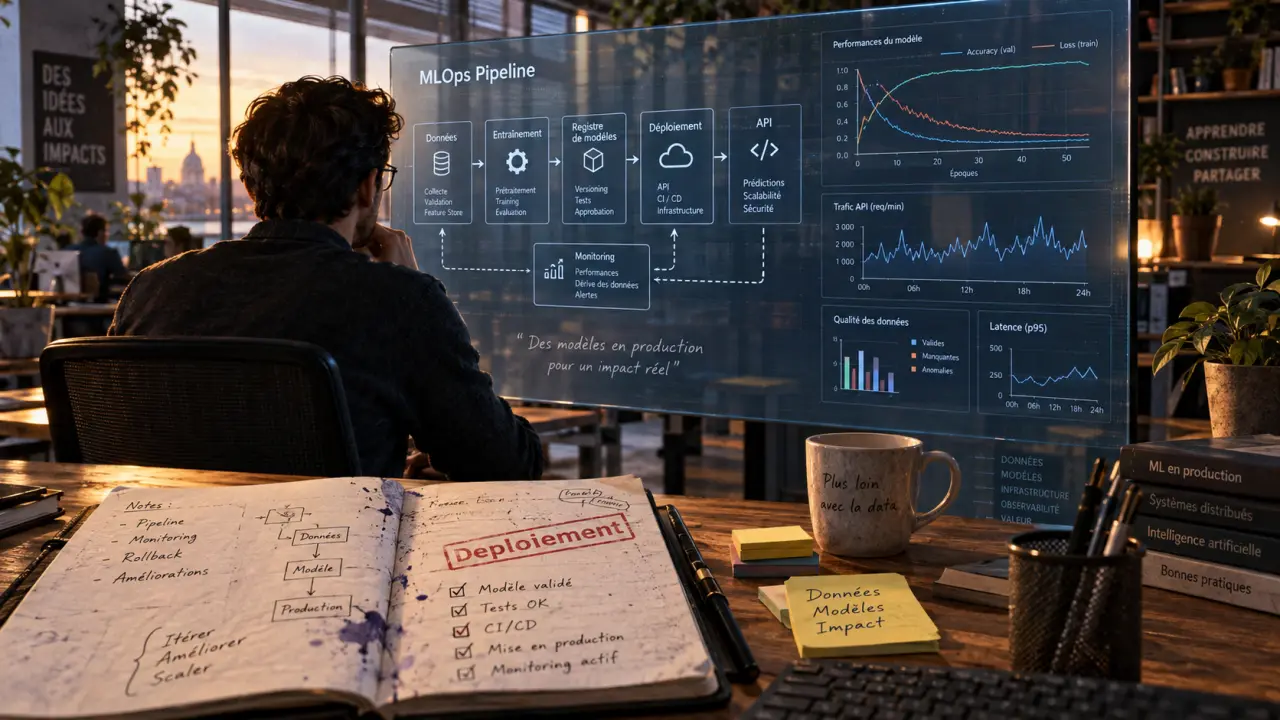
Un consultant machine learning aide une organisation à transformer ses données en décisions, automatisations ou prédictions utilisables. Son intervention ne s’arrête pas à l’entraînement d’un algorithme : il clarifie le besoin métier, évalue la qualité des données, choisit une méthode adaptée, organise le déploiement et prépare le suivi du modèle. Cette approche devient particulièrement utile lorsqu’un projet d’intelligence artificielle doit dépasser l’expérimentation pour produire un résultat mesurable.
Un rôle de traducteur entre besoin métier, données et production
Le consultant machine learning travaille à l’interface des équipes métier, data et IT. Il commence par préciser la décision à améliorer : anticiper le churn, estimer des volumes, recommander un produit, extraire des informations de documents ou détecter des incohérences. Cette étape évite de lancer un projet technique autour d’une question imprécise ou de données impossibles à exploiter.
Il traduit ensuite cet objectif en problème de machine learning : classification, régression, clustering, séries temporelles, système de recommandation ou traitement automatique du langage. La réussite ne dépend pas uniquement du score de précision. Le consultant prend aussi en compte le coût d’une erreur, le délai de réponse, la confidentialité, l’explicabilité et l’adoption par les utilisateurs. Un modèle performant sur le plan statistique peut rester inutile s’il est trop lent, trop coûteux ou difficile à intégrer dans les habitudes de travail.
Le POC n’est pas encore une solution
Une preuve de concept montre qu’un modèle peut fonctionner sur un périmètre donné. Une solution de production doit recevoir de nouvelles données, résister aux changements, fournir ses résultats au bon moment et rester maintenable. Le consultant identifie donc rapidement les contraintes d’intégration, d’infrastructure cloud, de sécurité et de gouvernance des données. Il évite ainsi le cas d’un notebook convaincant qui ne trouve jamais sa place dans les processus de l’entreprise.
Ce que fait concrètement un consultant machine learning pendant une mission
Une mission structurée suit un cycle complet, avec une intensité variable selon la maturité de l’entreprise. Dans une PME, le consultant peut poser les premières bases data et formaliser le cas d’usage. Dans une organisation déjà équipée, il intervient davantage sur le modèle, le MLOps, la qualité des données ou le passage à l’échelle.
- Cadrer le cas d’usage : définir l’objectif opérationnel, les utilisateurs concernés, les indicateurs de succès et les limites à respecter.
- Auditer les données : repérer les sources disponibles, les biais, les doublons, les valeurs manquantes, les règles d’accès et la fraîcheur des données.
- Préparer et modéliser : nettoyer et transformer les données, créer des variables pertinentes grâce au feature engineering, puis entraîner et comparer plusieurs approches.
- Valider : confronter les résultats aux attentes métier, tester la robustesse et documenter les limites du modèle.
- Déployer et suivre : intégrer le modèle dans une API, un pipeline ou une application, surveiller ses performances et planifier son réentraînement.
Des livrables qui rendent la mission pilotable
Un bon consultant ne livre pas seulement du code. Selon le projet, il remet une note de cadrage, un diagnostic de qualité des données, un rapport d’analyse exploratoire, un prototype, un pipeline de production, une documentation technique et un plan de monitoring. Pour les équipes métier, il peut aussi fournir un tableau de bord, une restitution des résultats et des règles d’usage claires. Ces livrables permettent de suivre l’avancement, de vérifier les choix réalisés et de faciliter le transfert aux équipes internes.
Surveiller la dérive avant qu’elle ne devienne invisible
Un modèle reste fiable seulement si les conditions qui ont permis son apprentissage restent suffisamment proches de la réalité. Si les comportements clients, les règles de saisie ou la distribution des données changent, les variables d’entrée ne portent plus la même information. Le monitoring doit donc suivre la dérive des données, la qualité des prédictions, la latence, les erreurs techniques et les écarts entre résultats attendus et observés. Cette surveillance permet de décider quand analyser un incident, ajuster le modèle ou lancer un réentraînement.
Compétences et outils : une expertise technique au service du terrain
La base technique associe statistiques, modélisation mathématique, programmation et compréhension des données d’entreprise. Python est très courant, notamment avec NumPy, pandas et scikit-learn. SQL est indispensable pour interroger, contrôler et préparer les données. R peut également être utilisé dans certains environnements analytiques.
Le consultant doit connaître les méthodes supervisées et non supervisées : classification, régression, clustering comme K-means, scoring, séries temporelles et, selon le besoin, deep learning. Les projets de NLP, de LLM, d’embeddings, de vision ou de classification sémantique demandent des compétences complémentaires. Ils ne justifient toutefois pas automatiquement une solution complexe. Le choix doit rester proportionné au problème, aux données et aux coûts d’exploitation.
Cloud et MLOps pour rendre le modèle exploitable
Les environnements AWS, Azure et GCP sont fréquemment mobilisés pour stocker, entraîner et déployer les modèles. Le consultant peut aussi travailler avec Jupyter Notebook, Dataiku DSS, Snowflake, Docker, des outils de CI/CD et des solutions de job scheduling. Le MLOps relie ces composants : il permet de versionner les données et le code, d’automatiser les tests, de déployer de manière reproductible, de tracer les versions du modèle et de superviser la production.
La technique ne suffit pas. Le consultant doit expliquer les résultats à des décideurs non spécialistes, arbitrer entre précision et interprétabilité, puis justifier une prédiction sensible lorsque cela est nécessaire. Des méthodes d’explicabilité comme SHAP aident l’équipe à comprendre les facteurs qui influencent une recommandation ou un score. La sécurité, la conformité, la gouvernance des données et la maîtrise des biais font aussi partie du travail lorsque le modèle intervient dans une décision importante.
Consultant, data scientist, ML engineer : qui intervient sur quoi ?
Les frontières varient selon les entreprises, surtout dans les petites équipes. La différence se joue souvent dans la priorité donnée au conseil, à l’analyse, à l’ingénierie ou à la mise en œuvre applicative.
| Rôle | Priorité principale | Contribution typique |
|---|---|---|
| Consultant machine learning | Résoudre un besoin métier de bout en bout | Cadrage, modélisation, recommandations, déploiement et transfert |
| Data scientist | Analyser et modéliser les données | Expérimentation, analyses prédictives et évaluation des modèles |
| Machine learning engineer | Fiabiliser et industrialiser | Pipelines, API, performance, infrastructure et production |
| AI engineer | Construire des fonctionnalités IA | Intégration de modèles, LLM, applications et expérience utilisateur |
| Data analyst | Éclairer la décision | Tableaux de bord, indicateurs, analyses descriptives et visualisation |
Pour une entreprise, le consultant est pertinent lorsqu’il faut choisir le bon cas d’usage, coordonner plusieurs interlocuteurs et obtenir une solution utilisable. Pour un candidat, cette dimension de conseil demande de développer autant la capacité de restitution que la maîtrise des algorithmes. Le profil doit comprendre les contraintes du terrain et savoir transmettre ses choix aux équipes qui utiliseront ou maintiendront la solution.
Accéder au métier, évaluer les opportunités et choisir le bon profil
Une formation en data science, informatique, statistiques, mathématiques appliquées ou recherche opérationnelle constitue une base solide. Les parcours peuvent commencer après un Bac +3 pour un MSc, tandis qu’un BSc post-bac peut durer 4 ans. Les projets réalisés, l’expérience avec des données imparfaites et la capacité à livrer en production pèsent toutefois fortement dans une candidature. La connaissance des outils ne remplace pas la capacité à relier un modèle à un besoin opérationnel.
Salariat, freelance et évolution professionnelle
La rémunération dépend du secteur, de la localisation, de l’autonomie, de la spécialisation et de l’exposition à la production. emlyon indique environ 3 500 € brut mensuels pour un débutant, 4 500 à 5 000 € brut mensuels en moyenne et plus de 6 000 € brut par mois pour un profil senior. Dans les offres de missions, on trouve aussi des repères allant de 40 000 à 45 000 € par an et des TJM de 500 à 650 € par jour. Ces montants ne remplacent pas l’évaluation du périmètre, de la durée, des responsabilités et des frais liés au statut indépendant.
Le freelance doit présenter des réalisations compréhensibles : contexte initial, données disponibles, choix techniques, contraintes de déploiement, indicateurs suivis et limites rencontrées. Une expertise sectorielle en finance, commerce, industrie, santé ou marketing peut renforcer la pertinence d’une proposition. La capacité à expliquer ce qui a été livré et ce qui reste à améliorer compte autant que la liste des technologies utilisées.
Les critères pour sélectionner un consultant
- Une expérience démontrable sur des projets déployés, pas uniquement sur des prototypes.
- Une méthode de cadrage reliant indicateurs métier, données disponibles et décisions à prendre.
- Une pratique de la qualité des données, de la sécurité, de la conformité et de l’IA responsable.
- Des compétences adaptées à l’environnement existant : cloud, outils data, CI/CD et équipes internes.
- Des livrables précis, un dispositif de monitoring et un plan de transfert de compétences.
Le meilleur choix n’est pas forcément le profil qui propose le modèle le plus sophistiqué. C’est celui qui sait formuler un problème utile, évaluer la valeur du résultat et organiser sa fiabilité après la mise en production. L’entreprise doit donc examiner le périmètre d’intervention, les méthodes de suivi et la capacité du consultant à travailler avec les équipes déjà en place.